

400-820-8531
 图1. 源于质谱的蛋白酶质组学简要(图源:Shuken, J Proteome Res, 2023)
01.数据表格了解:多肽签定
累计LC-MS/MS正常运行生产的原使信息集是一种个大的光谱仪图偏序,每光谱仪图都会开展时段、m/z值、硬度和元信息。利用MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等APP包治疗这类信息,提取肽和/或蛋清质汇总,每鉴别都会一种总分。基本上数非靶向疗法的自下而上的DDA蛋清质组学实验报告中用到的最易见的肽鉴定会具体方法为信息库搜索网页(图2)。
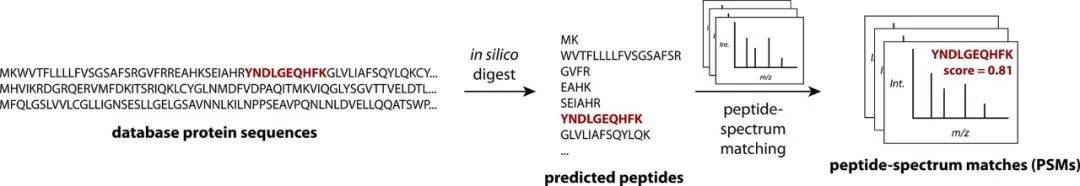 图2. 的数据关注的抽象化分析(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的氨基字段(图源:Shuken, J Proteome Res, 2023)
 图4. 片断m/z值、带注解的MS2谱,各类图3中鼓起彰显的片断回文序列(NILIDFTK)
1.1 统计资料库关注计算方法范例:SEQUEST的细化介绍
SEQUEST是1993年发稿的首届全自行肽判断应用。图5多媒体演示了SEQUEST聚类算法的简化版基本概念。首要,对对比淀粉酶质组预測的肽做好净化系统,便于只考虑到与分离法的断阴正离子的m/z值相近的前体(即带电粒子的情况特女性朋友肽阴正离子),随后生产基本原理光谱图图图图仪仪图仪分析图仪(图5,上方)。借助将實驗光谱图图图图仪仪图仪分析图仪与预測电影精彩片段的m/z值做好粗略地相对比较,基本原理光谱图图图图仪仪图仪分析图仪被更快净化系统,输入电影精彩片段的需求量、MS2难度和各种各种相关特征英文搭档成一两个总成绩,仅留下应用场景该总成绩的前500个基本原理光谱图图图图仪仪图仪分析图仪(图5,环节1)。借助清理前体峰,将光谱图图图图仪仪图仪分析图仪区划为二十个一样 的部位中,并将每一家部位中的难度归一改成相当的值来調整實驗光谱图图图图仪仪图仪分析图仪(图5,环节2),这每一步使實驗光谱图图图图仪仪图仪分析图仪更非常接近基本原理光谱图图图图仪仪图仪分析图仪,削减了在校园营销推广活动的环节之中所构建基本原理光谱图图图图仪仪图仪分析图仪时无视的可变性震碎的破碎化速率的。借助将每一家m/z值处的难度相乘并将乘积之和,运算實驗光谱图图图图仪仪图仪分析图仪与每一家基本原理光谱图图图图仪仪图仪分析图仪彼此间的彼此相互影响(图5,环节3)。
 图5. 简单了原SEQUEST数据统计库搜寻svm算法的设计方案(图源:Shuken, J Proteome Res, 2023)
1.2 肽签定中的FDR管理
我国怎样取决什么样均衡分充裕高来提出真實的ID?阶段 ,最畅销的策略是 Target-decoy搜素(图6)。该的过程把握整体错识会发现率(FDR),即被收到的PSM错识的均衡配比。为了让在把握FDR的同一上限容许地检查测量真肽,可以食用搜素均衡分和PSM的别的有特点的直线女子女子组合(图6)。直线女子女子组合中食用的数值{a, b,…}被调优以上限容许地检查测量真肽,常食用percolator食用的工具掌握百度算法。再此调优完毕后,大多数高于需求FDR相对阈值法的要求相匹配(假如,1%)被补齐。此进行过滤数据库集的FDR叫做“整体”FDR。
 图6. Target-decoy搜所。PSM=肽谱识别;FDR =不正确的察觉到率(图源:Shuken, J Proteome
02.肽段酶联免疫法
提优质率色谱仪色谱在某个启用的过程中中间隔地将多肽喷到质谱仪中。没个扫描机阶段一下,一般性需求3 s或更少有,光谱分析图仪引发MS1光谱分析图;于是,在提优质率色谱仪气相色谱柱过柱的过程中中,前体的MS1峰有时候被观察植物到无数次,那些MS1数据库点一同确立色谱峰(图7A)。给定其他的肽,其色谱峰的特色,要是高宽比或等值线下列积(AUC),也可以于测试肽的比丰度,这被叫做非标设备记降钙素原检测(LFQ),该技巧也可以于不一样原材料中的用量会比较。 以便延长参考值再次出现性、备样通量和/或数据统计完成性,箭头实验试剂也能于参考值同个质谱中的2个菌物备样。在许多的措施中,除区别的放射性核素产生肽或其片断的m/z值区别外,肽被箭头为相似的分子群,时候保持化学上的性,如保持時间、电离性和片断模试。在代谢率箭头的措施中,如组织细胞锻炼酪氨酸稳固放射性核素箭头(SILAC),施用菌物系统软件将含有重放射性核素的酪氨酸箭头全部核蛋清酶质组。在备样准备做出时,将绿色“轻”核蛋清酶与重核蛋清酶结合在一起,那么与MS1光谱仪做出比效(图7B)。在等压法(即重量成正比,由于区别的那些固化的标签极具相似的总重量)箭头的措施中,如结合重量那些固化的标签(TMT),肽段在吸收后被箭头,那么在LC-MS/MS前组合公式。高激光CID(HCD)为其他菌物备样挥发区别的汇报范文亚铁化合物;用MS2或MS3检测侧量汇报范文亚铁化合物抗压强度,能推测出比丰度(图7C)。施用LFQ,每一回自动加载研究两个菌物范例;施用SILAC,每一回自动加载一般 研究两到五个菌物范例;施用TMT,一回能研究几瓦18种区别的菌物范例。
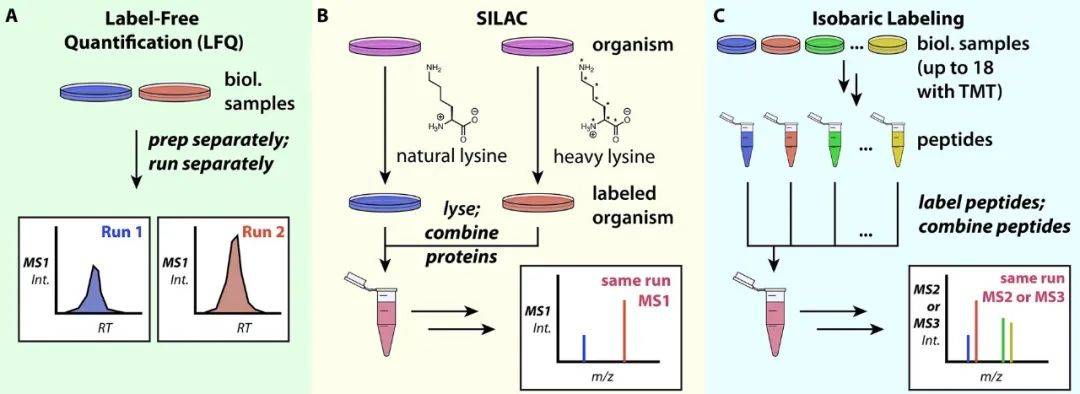 图7. 多肽按量最简单的方法。A.在MS1平均水平去非标准件记按量;B. 内部训练中安基酸保持稳定放射性核素记号(SILAC);C. 等压记号
03.“蛋白酶酶质总体水平”:判断蛋白酶酶质的形态和丰度
3.1 血清质推算与分类
总之这种选择自下而上血清酶质组学涉及了“血清酶质”的地位和数据,但它们的普通是司法技术鉴定和/或确定血清酶质群,其渊源的血清酶质或基因组有机会是不确定的。而对于类似这种模棱两可,最易见的很好解决计划书是选择每隔PSM为图纸中发生合适血清酶质的证人证言。若果一列血清酶质中有一样的证人证言(即血清酶质回文编码序列与统一列司法技术鉴定的肽回文编码序列筛选,如同8中的血清酶质V和VI),则将这种血清酶质整合为两个血清酶质组(PG)。若果两个血清酶质的筛选肽是另两个血清酶质的子集,则该血清酶质普通被判定在报告模板后,而较弱该血清酶质特别肽但其肽并非是子集的血清酶质可称可涵盖血清酶质。
 图8. 蛋白酶质推断出和好友分组手段(图源:Shuken, J Proteome Res, 2023)
3.2 蛋白酶总体水平FDR抑制
通常数制定淀粉酶质排列的潮流手机软件包,如MaxQuant和Proteome Discoverer,也就能够 算出淀粉酶质技术鉴定结论FDR的推测,并将其坏点重新调正到可联受的技术。有多的方法就能够 掌控淀粉酶质技术的FDR。其中一种可以直接的机制是巧用因素PGs,即完全性由因素PSM构造的PG,两者被主动保存并接受与工作目标值PSM比如的淀粉酶质推论时候。为4个工作目标值和因素PG共建的高考分数,禁止以与PSM FDR比如的习惯掌控淀粉酶质技术FDR(图6)。3.3淀粉酶组参考值
多肽和淀粉酶质相互间关联的供需双地方引响使这一种阶段有难度化。PG内的肽将会在同旁内角自动匹配的淀粉酶质中真正的爱情不相同,这将会会引响同旁内角的丰度(图8)。要是PG中的肽是该PG所独到的,这里是有辅助的,准许对单体淀粉酶质做好明确。以至于,有难度的是肽将会所产生于所含英译后绘制的淀粉酶质,其丰度引响肽的难度,除此以外,主要是因为DDA本身的随机的性,一定肽将会在一种产品的样品英文中观擦到而在另一类种产品的样品英文中观擦不足。受欢迎的信息工作应用包为移动用户出具询问决这其他原因的的选择项。基本数应用(属于MaxQuant)只准许对PG-unique肽做好按量。一定(如Spectronaut ,Biognosys)准许非常多的规模,如的限制按量到淀粉酶质特女性朋友肽,或的选择是否是便用肽难度的中六十位数、和、数学测算大概值或是多少呢大概值来测算PG次数。关于LFQ,什么值得需要注意的是MaxQuant中控制的受欢迎的MaxLFQ梯度下降法。当在不相同的模本中区分出不相同的前体集时,MaxLFQ经过所采用可以用在的两两较好和便用中六十位数比列来较好PG来工作缺乏值。等压标注和信息单独的提取(DIA)是缩减或消减缺乏值的其他的形式。3.4 统计显示定性分析和生物技术学描述
若果估算出PG的相数目,通过工作的菌物学基本特性,都能能动用各种各样的軟件工具对毕竟完成核算显示解析和表达。Perseus和MSStats是制作代替蛋清质组数目正确处理和核算显示解析的流行趋势軟件包。测算数据深入分析也都能能动用程序设计程序语言(如python或R)人工机械解析。在通常情况相对比较蛋清质组学工作中,也包括从所有中洗去被污物或钓鱼诱饵,动用常用对数使数目相似度高正态分布图,将测算数据深入分析归一化以处理作业间的技术应用进化性,动用核算显示测试(如t测试/方差解析/直线再战)测试变换,并对毕竟p值完成多假如说测试。 数据显示统记浅析做好后,报告单也能在怪物学解釋。Gene Ontology是的研究在测试中遭受改动的怪物路径的一些流行时尚数据显示库。STRING能提供了有关于感喜好的球脂肪酸期间已经知道影响或能够 意义的的信息。相应浅析,如加权平均法dna相应手机网络数据浅析(WGCNA),只能根据测试中球脂肪酸丰度变现的类似于状态创造出一个球脂肪酸手机网络数据,这也能进这一步知道测试中球脂肪酸期间的影响。在全方位的解釋以上浅析的报告单,怪物学假如说也能取到支持系统或驳斥,如果也能生成新的假如说。04.拜谱微生物分析:质谱事业环节
某种程度就,非标设备记的自下而上的事业工作流程相应: (1)剥离组织开展/沉水植物、融解神经细胞;用尿素溶液和/或去垢剂使核氨基酸性变。 (2)用DTT或TCEP等策略限制二硫化橡胶物;用IAA烷基化半胱氨酸。 (3)用冷甲苯、氯仿-甲醇凝固法或磁珠凝固法大部分纯化核营养素(有部分工做具体流程不利用危险的去垢剂如SDS,可跳过去这一个步骤)。 (4)用胰蛋清酶酶或LysC乐队组合蛋清酶酶代谢蛋清酶质。 (5)用C18包被的过滤水吸管头离心力力清洁工作/脱盐多肽;用真空室离心力力机等减压蒸馏石油醚。 (6)将肽重悬于LC-MS兼容的溶剂中,举例说明0.1%甲酸水溶剂;适用有效的医疗仪器的办法做出LC-MS/MS研究分析;在正常运行结束后索引初始数据源。 (7)动用比较适合的手机电脑软件包治理原本数剧,如MaxQuant或Proteome Discoverer,或手机电脑软件包的组合成,下达数剧库搜所、FDR操控、相对于降钙素原检测和血清质判断。 (8)使用的编写程序语言的(如python或R)或游戏包(如Perseus或MSStats)连接统计表进行分析。 (9)依据实验性的生命科学学工作原理来解释清楚的结果;这就可以经由线路或网络信息级概述資源(如Gene Ontology、STRING或WGCNA)来辅助制作。 05前列题材
代替DDA便用的非靶点疗法自下而上的无符号符号球脂肪酸组,也有更加多的来源于质谱的做法来深入酶联免疫法深入分析球脂肪酸组(图9)。仪器设备和算法为基础均在开拓创新的更新系统,详细删改球脂肪酸、至上而下和绿色质谱法也用做酶联免疫法深入分析低多样化性的样本量;球血清的译员后掩盖而使至关关键性的调整用拥用巨大的深入酶联免疫法深入分析乾坤。格局设计球脂肪酸组学、生物球脂肪酸组学和将近符号符号等技巧便用生物、酶或热技巧来验测球脂肪酸,为深入酶联免疫法深入分析球脂肪酸格局设计、生物、位置定位、球脂肪酸-配体互相用或球脂肪酸-球脂肪酸互相用抢占了大批量的将会。相比之下DDA,的数据文件源自己的数据文件的数据文件采集(DIA)种越变越盛行词的的数据文件的数据文件采集做法,最盛行的DIA做法是来源于SWATH-MS,里面全MS1面积内的所以m/z值在不同扫一扫定期内都涉及到在灵魂碎片中,这大大大挺高了的数据文件源详细删改性,加大了球脂肪酸组学深浅。在靶点疗法球脂肪酸组学中,种特定的的球脂肪酸或四组球脂肪酸被做酶联免疫法深入分析的任务,其任务是狠抓很久做法运营时都能验测到任务球脂肪酸(的数据文件源详细删改性好),最大的可能地挺高灵活度和技术性面积,并且酶联免疫法为准性和精密加工度。 对於大总量的营养物质质亲子鉴定和一定量,质谱法是现最畅销的方案,在在未来,质谱与某些非质谱工艺的组合应用就能够越来越入地知道全部整个植物学学中的营养物质质组。
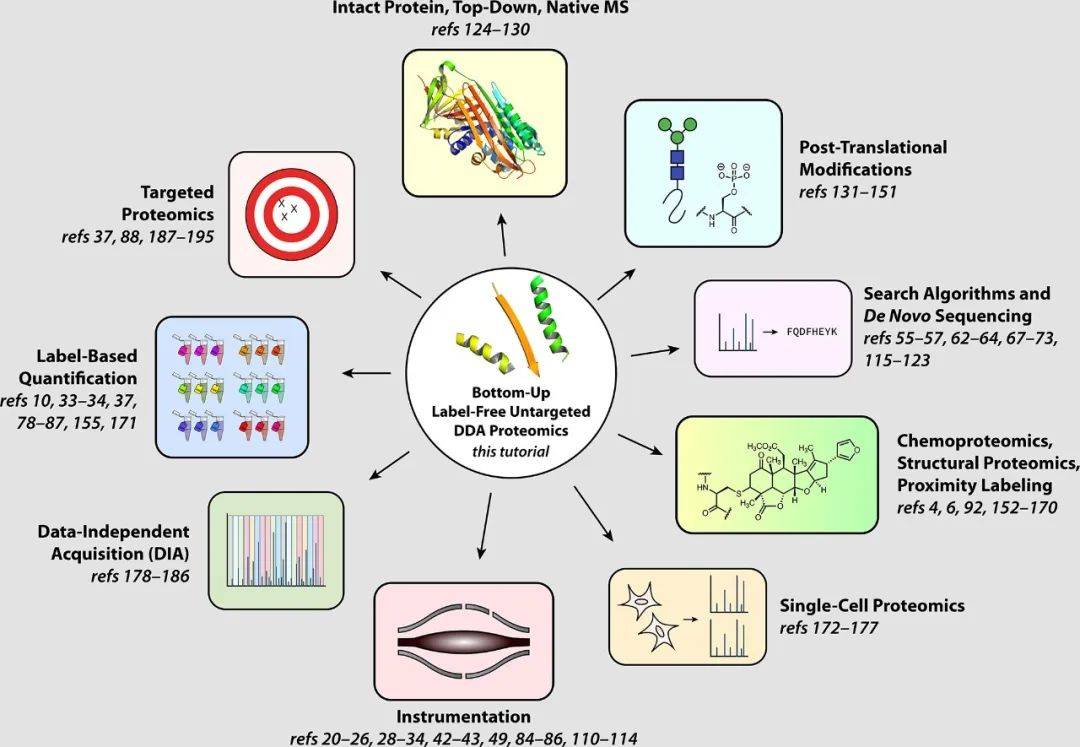 图9. 立于质谱的氨基酸质组学的子行业(图源:Shuken, J Proteome Res, 2023)
基准文献综述:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 观注公共号


 关注度小华书


